Klein aber oho? Einsatz kleiner Sprachmodelle als Schritt zur Umsetzung des Code of Conducts Demokratische KI bei CorrelAid

Letztes Jahr haben wir den Code of Conduct for Democratic AI unterzeichnet. Nach mehreren Diskussionen zu den acht Prinzipien kamen wir zu einer Arbeitshypothese: Kleine Sprachmodelle könnten einige der gesellschaftlichen Herausforderungen großer KI-Modelle abmildern. In einer dreiteiligen Workshop-Reihe haben wir gelernt, wie man kleine Sprachmodelle lokal ausführen kann und wir haben auch herausgearbeitet, wie das uns bei der Umsetzung demokratischer KI hilft.
Danke an alle Beteiligten für eure Unterstützung! Wir freuen uns darauf, den Dialog weiterzuführen – denn die rasanten Entwicklungen in der KI-Sphäre machen eine kontinuierliche Umsetzung des CoC in unserer Community unverzichtbar.
Genau wie die Workshop-Reihe verbindet auch dieser Blogpost “Tech & Talk”: Zunächst legen praktisch dar, wie kleine Sprachmodelle lokal genutzt werden können, bevor wir unsere Reflexion darüber, wie das den Code of Conduct demokratische KI unterstützt, dokumentieren.
Kleinere Modelle brauchen “Skull & Brain"
In unserer Workshop-Reihe nutzte CorrelAid-Volunteer Chris, der den technischen Part leitete, die Metapher „Skull & Brain“ (Schädel und Gehirn), um zu erklären, wie kleine Sprachmodelle lokal laufen.
Neben dem trainierten Modell – dem Gehirn, braucht einen Schädel, sprich eine Art Hülle, mit der die Frage verarbeitet und eine Antwort inferiert werden kann. Es funktioniert ähnlich wie ein Chatfenster, doch dahinter steckt mehr: Es nimmt den Eingabebefehl auf und nutzt die Trainingsdaten, um eine Antwort zu generieren. Das ist in etwa vergleichbar mit einer Vorhersage eines klassischen Machine Learning Modells.
Je kleiner das Sprachmodell in Bezug auf seine Trainingsparameter ist, desto weniger Rechenleistung braucht es für diese Ausführung. Die Definition „klein“ reicht bis zu zehn Milliarden Parametern (laut Hugging Face). In unseren Workshops konzentrierten wir uns auf Modelle mit etwa drei Milliarden Parametern – sie laufen auf fast jedem Computer eines:r typischen europäischen Nutzer:in.
Wie nutzt man kleine Sprachmodelle mit LM Studio?
Es gibt verschiedene Wege, kleine Sprachmodelle (SLMs) lokal auszuführen. Im Workshop haben wir Ollama, LM Studio getestet und sogar ein Modell von Grund auf in Python nach Karpathys Anleitung selbst gebaut. Hier geht es um die Nutzung von LM Studio, da es zu keine komplizierten Kommandozeilen-Anforderungen hat und daher sehr einfach zu installieren und zu bedienen ist.
Falls du noch bessere Open-Source-Optionen kennst, lass uns gerne wissen!
- Herunterladen der Inferenzmaschine
https://lmstudio.ai/ - LM Studio installieren
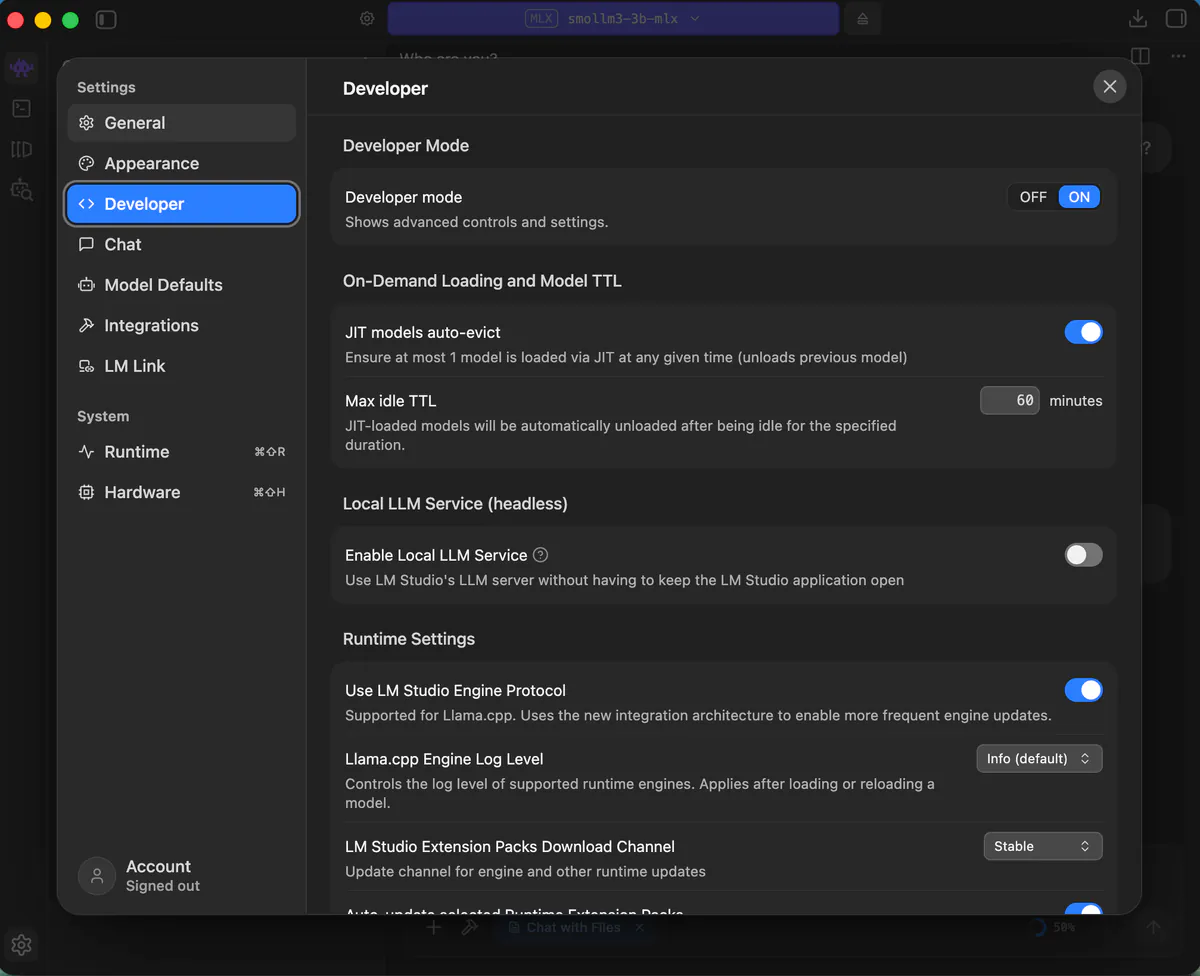
- Entwickler-Modus aktivieren
In den Einstellungen unter „Entwickler-Modus“ aktivieren – das gibt dir zusätzliche Infos zur Kontextgröße im Chat.
- Modell suchen und herunterladen
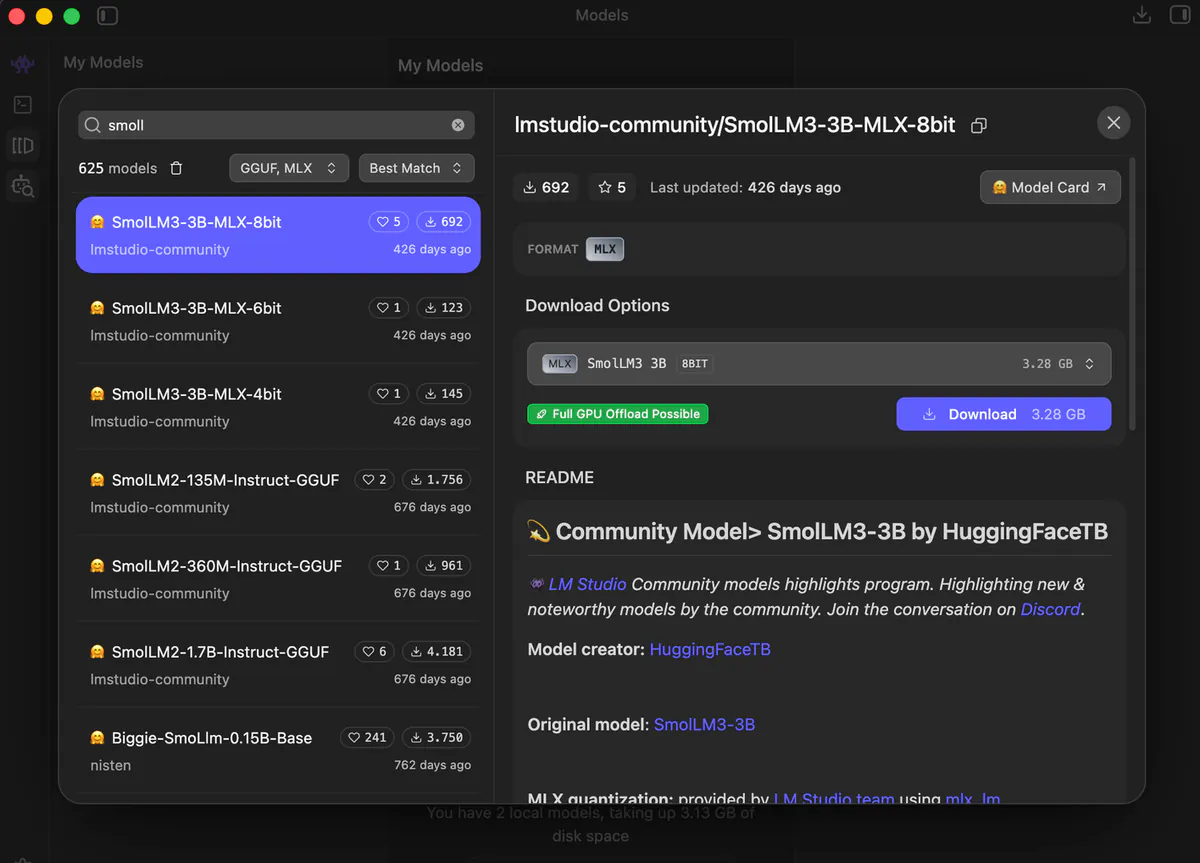
Das vierte Icon in der oberen linken Ecke (ein kleiner Roboter mit Lupe) führt zu einer Integration mit Hugging Face – quasi ein Marktplatz für Modelle. Dort kannst du nach einem Modell suchen und dann auf den violetten „Herunterladen“-Button klicken.
Achtung: Das MLX-Format ist für Macs geeignet, während das gguf-Format besser zu anderen Betriebssystemen passt.
Je nach Bandbreite dauert das Herunterladen ein paar Minuten.
Welches Modell soll ich wählen?
In unseren Workshops haben wir mit zwei Modellen gearbeitet:
- SmolLM3-3B-MLX-8bit (ein open Source Modell)
- ministral-3-3b (ein Modell einer europäischen Firma)
Es gibt aber noch viele weitere Optionen. LM Studio warnt dich auch, falls das Modell zu groß für deinen Computer ist.
- Modell laden, chatten und Halluzinationen im Blick behalten
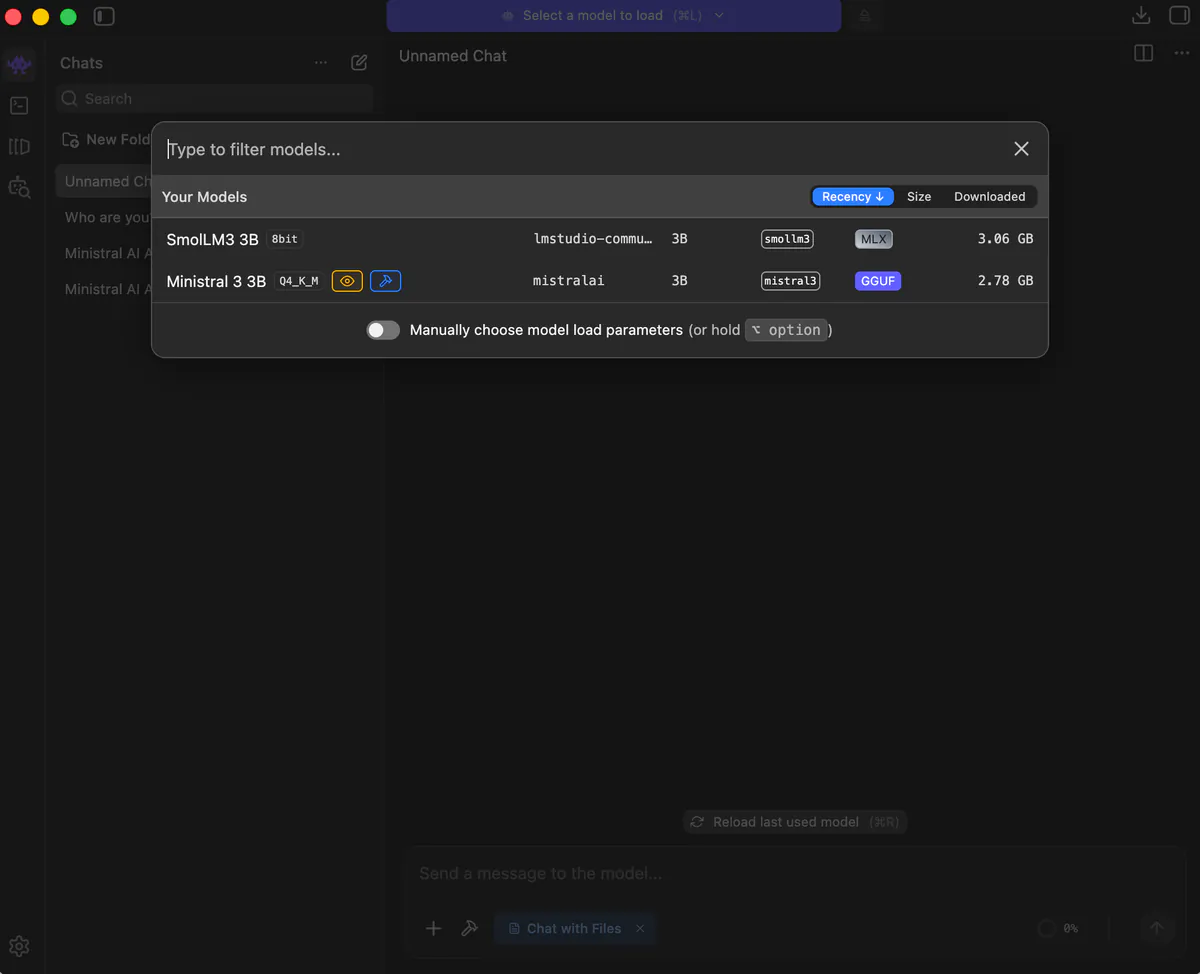
Klicke auf das erste Icon in der oberen linken Ecke, dann kannst du den violetten Balken anklicken und so du ein zuvor heruntergeladenes Modell auswählen.
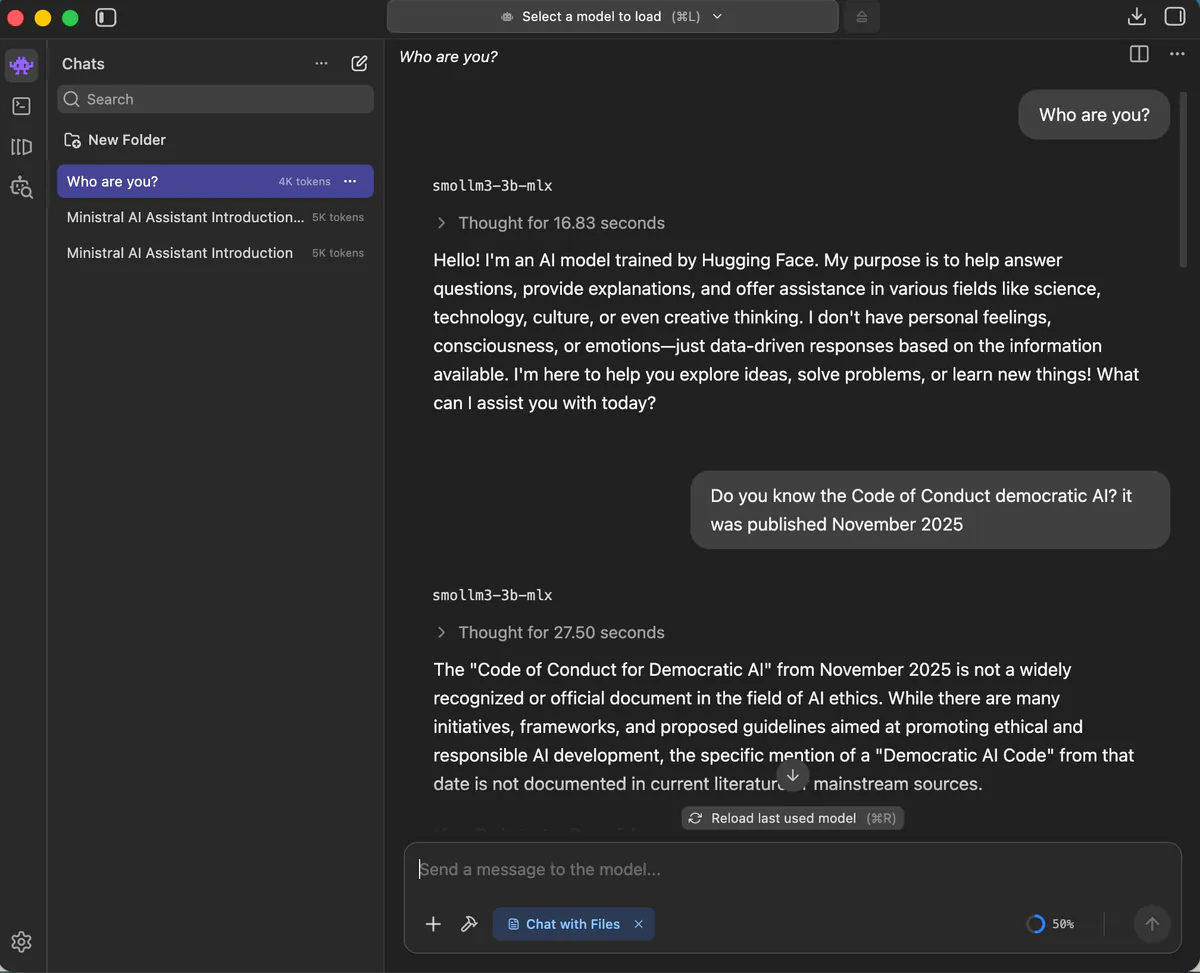
Beim Chatten solltest du immer bedenken, welche Informationen tatsächlich zur Trainingszeit verfügbar waren. Fragen wie *„Wer bin ich?“ oder „Wann wurde ich zuletzt aktualisiert?“ helfen dabei, die Antworten der KI zu bewerten. Zum Beispiel führte unsere erste Frage zum CoC demokratische KI Halluzinationen hervor. Nicht wegen eines zu vollen Kontextfensters, sondern weil das Modell smollm3 mit Daten bis Dezember 2021 trainiert wurde und der Code of Conduct erst im November 2025 veröffentlicht wurde.
- Dokument hinzufügen und Modell darauf anwenden
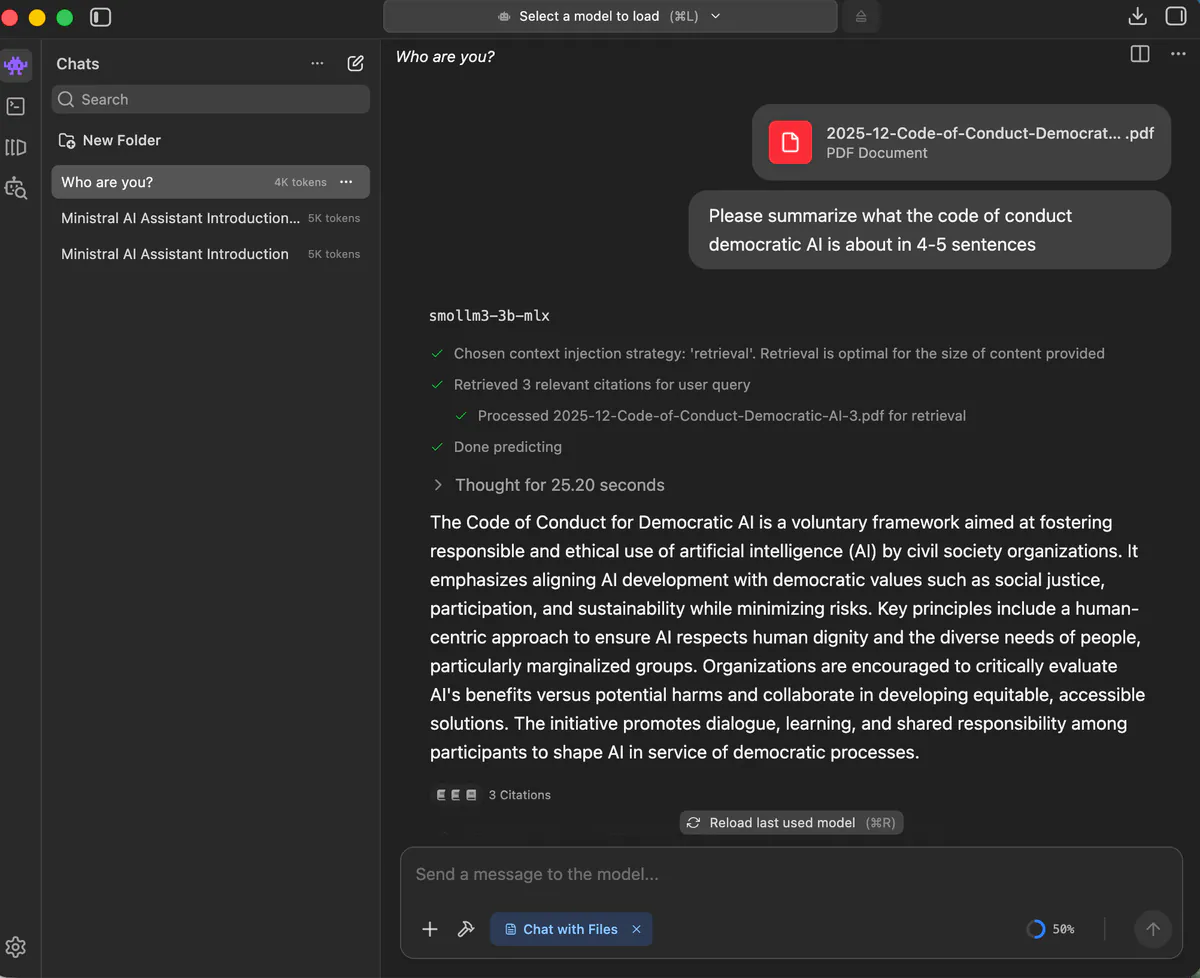
Damit das Modell für uns eine sinnvolle Antwort auf den CoC liefern kann, können wir einfach dieses Dokument hochladen und dann mit dem Chat arbeiten. Das bedeutet: Wir wenden die Modellausgabe (inference) auf neue Daten an – ein einfacher RAG-Ansatz (Retrieval-Augmented Generation), der in LM Studio besonders leicht umzusetzen ist. Klicke einfach auf das Plus-Symbol, füge dein Dokument hinzu und fertig.
In diesem Screenshot siehst du: Sobald wir den CoC demokratische KI hochgeladen haben, fällt die Halluzination weg. Die Antwort basiert nun direkt auf dem hochgeladenem Dokument.
Tech & Talk: Wie hilft diese Workshop-Reihe bei der Umsetzung des CoC Demokratische KI?
Die gesamte Workshop-Reihe ist an sich auch ein erster Schritt der Umsetzung des Code of Conduct: Sie vermittelt nicht nur konkrete technische Fähigkeiten zur lokalen Nutzung kleiner Sprachmodelle, sondern enthält auch einen Diskussionsteil. Dadurch wird bei allen Teilnehmer:innen auch das Bewusstsein für nicht-technische Aspekte geschärft. Dies erachten wir bei CorrelAid als besonders wichtig in einem sich ständig wandelnden Umfeld wie der künstlichen Intelligenz.
Durch diese Diskussionen fanden wir tatsächlich einige Antworten darauf, wie kleine Sprachmodelle die Demokratisierung von KI unterstützen können. Natürlich gibt es keine perfekte Übereinstimmung mit allen Prinzipien des CoC, aber es gibt viele Überschneidungen.
Abwägung der Nutzung
Für unsere Aufgaben als Datenanalysten oder Data Scientists brauchen wir keine KI – noch weniger große Modelle. Wenn wir uns dennoch für die Nutzung eines Sprachmodells entscheiden, entschleunigt die Verwendung kleinerer Modelle den Prozess. Beim bewussten Auswählen eines konkreten Modells kann es einen Moment der Achtsamkeit geben. Denn bei kleinen Sprachmodellen ergibt es Sinn, spezifischere Modelle zu wählen.
Kompetenzen
Die Workshop-Reihe brachte einige „Aha“-Momente mit sich. Natürlich dauert es etwas länger, SLMs lokal einzurichten – aber genau dieser Prozess schafft ein tieferes Verständnis dafür, wie Sprachmodelle funktionieren. Zudem waren die Teilnehmer:innen überrascht, wie vielfältig die Auswahl an Modellen ist und dass nicht nur große Konzerne dabei mitspielen. Kurz gesagt: Unsere Workshopteilnehmer:innen steigerten ihre KI-Kompetenz, erhielten ein besseres Verständnis und mehr Optionen für ihre Modellauswahl.
Transparenz
Erstens, die lokale Chat-Funktion hält die eingegebenen Daten privat. Zweitens, durch SLMs haben Nutzer:innen mehr Kontrolle über ihre Daten und Interaktionen. Dies steht im Gegensatz zu großen Modellen, die immer online laufen müssen. Zudem können bei lokalen Modellen mehr Parameter gesteuert werden als bei großen Online-Modellen. Zum Beispiel kann die „Temperature“ (Grad der Zufälligkeit einer Antwort) oder das „top_p“ (Diversität der Antwort) angepasst werden.
Teilnhabe und Inklusion
Nach dem Workshop fühlten sich die Teilnehmer:innen weniger abhängig von großen Tech-Konzernen. Wir haben zudem getestet, wie wir durch den RAG-Ansatz die Trainingsdaten des Modells durch neue Dokumente erweitern können. Dies ist eine Form der Mitgestaltung und Weiterentwicklung eines Modells.
Diskriminierungskritische Haltung
Hier besteht eine Einschränkung: SLMs können tendenziell stärker verzerrt sein und mehr Halluzinationen produzieren. Das macht sie anfälliger für Diskriminierung. Um dieses Reaktion zu minimieren, ist es sinnvoll, Modelle gezielt für die jeweilige Aufgabe hin auszuwählen. Zum Beispiel könnte man für das Programmieren ein Modell nutzen, das speziell für Coding-Tasks trainiert wurde.
Ökologische Nachhaltigkeit
Kleinere und insbesondere spezialisierte Modelle benötigen weniger Energie beim Training, da sie nur Daten eines etwas abgesteckten Rahmen durchforsten müssen. Bei der lokalen Nutzung von SLMs verbraucht nur das Endgerät Energie. Das heißt, der Energieverbrauch ist deutlich geringer, als wenn ein großes Datenzentrum betrieben wird, wie es bei Cloudanbietern von KI der Fall ist.
Zusammenfassung
Die lokale Nutzung von SLMs ermöglicht es, bewusster, nachhaltiger und transparenter mit KI umzugehen. Sie stärkt die KI-Kompetenz der Nutzer:innen und gibt ihnen Kontrolle über ihre Daten zurück. Kurz gesagt: Es geht darum, in der dynamischen Welt der KI wieder etwas Eigenverantwortung zu übernehmen.
Bisher war “Tech & Talk” für uns als CorrelAid Community eine gute Mischung in unserem Prozess zur Umsetzung des CoC. Deshalb werden wir als CorrelAid-Community auch weiterhin diese Kombination weiterverfolgen, auch um den Prinzipien Verantwortung und Verantwortlichkeit sowie den Menschzentrierung gerecht zu werden.